Los algoritmos de admisión universitaria llevan años tomando decisiones que antes recaían en comisiones de profesores, tutores y rectores. Hoy, en muchas universidades de Estados Unidos, Reino Unido y algunos países de América Latina, un sistema automatizado lee tu expediente, pondera tus notas, tu código postal y hasta tus actividades extracurriculares, y te asigna una puntuación antes de que ningún ser humano haya leído tu nombre. El resultado es una promesa de objetividad que merece bastante más escrutinio del que suele recibir.
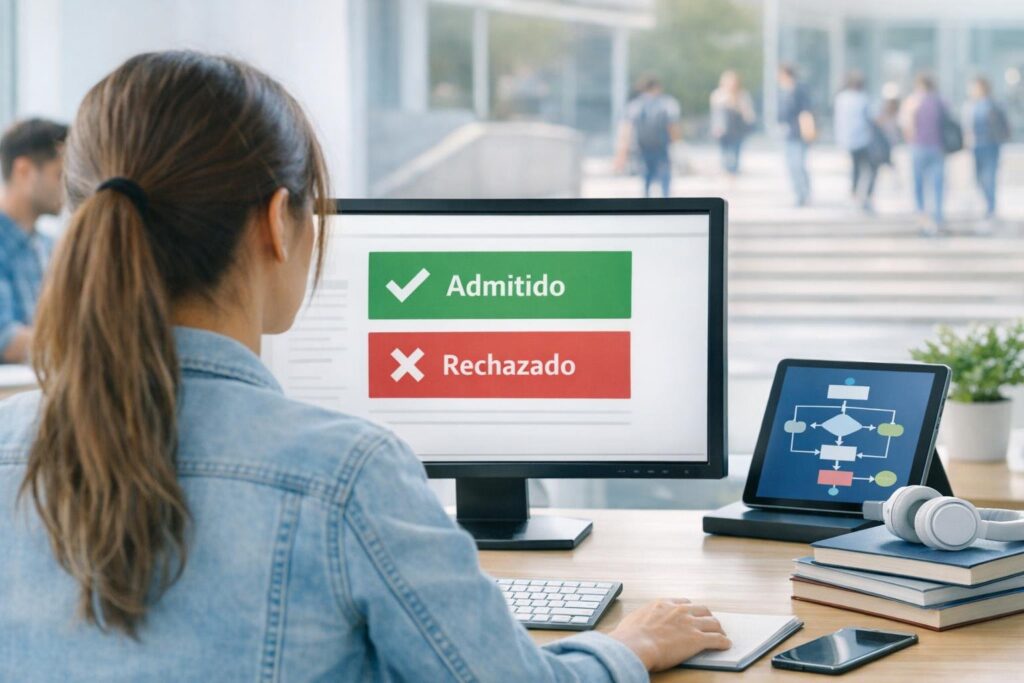
La automatización en los procesos de selección académica no es nueva. Las universidades llevan décadas usando fórmulas estadísticas para ordenar candidatos. Lo que ha cambiado en los últimos diez años es la opacidad y la escala: los modelos son más complejos, procesan más variables y, en muchos casos, ni las propias instituciones pueden explicar con claridad por qué un candidato supera a otro.
¿Cómo funcionan realmente los algoritmos de admisión universitaria?
Un algoritmo de admisión universitaria es, en esencia, un modelo que asigna pesos distintos a diferentes variables del expediente de un candidato. Las notas académicas, los resultados en pruebas estandarizadas como el SAT o el ACT en Estados Unidos, las cartas de recomendación codificadas numéricamente, los ensayos personales analizados con procesamiento de lenguaje natural: todo entra en la ecuación. El problema está en decidir qué pesa más y por qué.
Algunas universidades han empezado a incorporar modelos de machine learning entrenados con datos de estudiantes de años anteriores. La lógica es sencilla sobre el papel: si los alumnos con cierto perfil rindieron bien históricamente, el modelo aprende a priorizar ese perfil. El riesgo de esta lógica es que el pasado siempre arrastra sus propios sesgos. Si durante décadas una institución admitió principalmente a estudiantes de determinados colegios privados o códigos postales con alta renta, el modelo aprende que ese perfil es el del “buen estudiante”, y lo reproduce.
En 2019, la Universidad de Austin en Texas fue señalada por un informe del Center for Investigative Reporting porque su modelo de admisión penalizaba indirectamente a candidatos de zonas de bajos ingresos. La variable en cuestión no era la renta familiar de forma explícita, sino la “distancia al campus” combinada con el tipo de instituto de procedencia. El efecto discriminatorio era real aunque la intención declarada fuera neutral.
Este tipo de discriminación indirecta tiene nombre en estadística: sesgo algorítmico por variables proxy. Una variable proxy es aquella que no mide lo que parece medir, sino algo diferente que está correlacionado con ella. El código postal no dice nada sobre la inteligencia de nadie, pero sí predice, con bastante precisión, el nivel socioeconómico. Cuando un modelo usa el código postal como predictor de éxito académico, está usando la clase social como criterio de selección, aunque nadie lo haya escrito así en ningún reglamento.
¿Qué pasa con los datos personales que entregan los candidatos?
El proceso de admisión universitaria genera una cantidad de datos personales considerable. Notas, historial de asignaturas, resultados de exámenes, actividades extracurriculares, composiciones escritas, en algunos casos incluso perfiles de redes sociales revisados manualmente o de forma automatizada. No todos estos datos se quedan dentro de la institución. Como ya hemos visto al hablar de lo que ocurre con los datos sensibles una vez que salen de su contexto original, la trayectoria de esta información puede ser opaca y difícil de rastrear.
En Estados Unidos, el consorcio Common App, que gestiona las solicitudes de admisión a más de 1.000 universidades, acumula datos de millones de candidatos cada año. Common App ha colaborado con investigadores externos y ha vendido acceso a datos anonimizados para estudios académicos. La anonimización, sin embargo, tiene límites conocidos: cruzar variables aparentemente neutras puede reidentificar a personas con relativa facilidad, especialmente cuando el conjunto de datos es suficientemente detallado.
En Europa, el RGPD obliga a que los procesos automatizados de toma de decisiones con efectos significativos sobre una persona puedan ser explicados y recurridos. En la práctica, muchas universidades del continente no han adaptado sus sistemas a este estándar de forma satisfactoria, según varios informes de autoridades de protección de datos de Alemania y Francia publicados entre 2021 y 2023.
¿Puede un algoritmo de admisión ser más justo que un comité humano?
Sí, en algunas circunstancias. Los seres humanos también discriminamos, y lo hacemos de formas que a menudo ni reconocemos. Un comité de admisión compuesto exclusivamente por profesores de élite puede tener sesgos de afinidad hacia candidatos que se parecen a ellos mismos en origen, vocabulario o referencias culturales. Un algoritmo, al menos en teoría, aplica los mismos criterios a todos los candidatos sin que el humor del día ni el orden de lectura de los expedientes influyan en el resultado.
La clave está en “en teoría”. Un algoritmo es tan justo como los datos con los que se entrena y como las decisiones de diseño que toman quienes lo construyen. Si esas decisiones no se auditan de forma independiente, la aparente objetividad del sistema puede convertirse en una capa de legitimidad que hace más difícil cuestionar resultados injustos. Es más fácil recusar a un profesor que a una caja negra.
Esta tensión entre eficiencia y equidad ha llevado a algunos países a explorar modelos híbridos. En Chile, el sistema de admisión universitaria (el llamado PAES, sucesor de la PSU) combina pruebas estandarizadas con un puntaje adicional para estudiantes del 15% superior de su propio establecimiento, independientemente del nivel del colegio. La idea es corregir el efecto del origen socioeconómico sin eliminarlo del proceso. Es un intento de ajuste social explícito, y tiene sus propios críticos.
En el Reino Unido, varias universidades del Russell Group han empezado a usar herramientas de análisis predictivo para identificar candidatos de entornos desfavorecidos con alto potencial. Oxford y Cambridge han sido criticadas por no implementar estas herramientas con suficiente ambición, dado que sus tasas de admisión de alumnos de colegios públicos siguen siendo notablemente inferiores a la proporción de esos alumnos en la población general.
¿Quién audita los algoritmos que deciden tu futuro académico?
La respuesta corta es que, en la mayoría de los casos, nadie con capacidad real de intervenir. Las universidades privadas en Estados Unidos no están obligadas a publicar los criterios de sus modelos de admisión ni a someterlos a auditorías externas. Pueden cambiar el peso de cada variable de un año para otro sin notificarlo a los candidatos. La opacidad es, en la práctica, la norma.
Algunas iniciativas académicas intentan cambiar esto. El proyecto Algorithmic Fairness in Higher Education, impulsado por investigadores del MIT y la Universidad de Cornell, ha desarrollado metodologías para auditar modelos de admisión sin necesitar acceso al código fuente, usando solo los datos de entrada y salida. Los resultados publicados hasta ahora muestran patrones de sesgo sistemático en varios modelos analizados, aunque los nombres de las instituciones concretas no siempre se hacen públicos por acuerdos de confidencialidad.
El debate sobre la transparencia algorítmica en educación conecta directamente con preguntas más amplias sobre el control democrático de la tecnología. Si un algoritmo decide quién accede a una educación universitaria, que sigue siendo uno de los principales ascensores sociales en muchos países, sus criterios deberían ser públicos, auditables y contestables. Hoy no lo son, y eso es una elección, no una inevitabilidad técnica.
Vale la pena recordar que los errores en sistemas críticos raramente son accidentales. Como hemos documentado al hablar de los fallos más costosos de la informática, los sistemas mal diseñados o mal auditados acaban produciendo efectos que nadie quiso pero que tampoco nadie detuvo a tiempo.
La experiencia del Reino Unido en 2020 es el caso más documentado de lo que puede salir mal. El algoritmo desarrollado por Ofqual para sustituir los exámenes cancelados por la pandemia asignó notas a 280.000 estudiantes basándose en el historial académico de sus centros educativos. El resultado fue que miles de alumnos de colegios públicos vieron sus notas rebajadas respecto a las predicciones de sus profesores, mientras que los de centros privados las mantuvieron o las mejoraron. El escándalo obligó al gobierno británico a revertir el sistema en menos de dos semanas. Fue, en palabras del entonces secretario de Educación, Gavin Williamson, “un fallo inaceptable”. Fue también un experimento involuntario que mostró, con una claridad poco habitual, cómo un modelo mal construido puede reproducir injusticias sistémicas a escala industrial.
Los sistemas automatizados de selección también plantean preguntas sobre la privacidad que van más allá de los datos académicos. Algunas universidades estadounidenses han reconocido revisar los perfiles públicos de redes sociales de los candidatos. Otras han usado herramientas de terceros para analizar los ensayos de admisión en busca de señales de autenticidad, es decir, para detectar si el texto lo escribió el propio estudiante o alguien más. Estas herramientas de detección, que hoy se aplican también para identificar textos generados por IA, tienen tasas de error documentadas que afectan de forma desproporcionada a hablantes no nativos del inglés, según un estudio publicado en 2023 por investigadores de la Universidad de Stanford.
El mercado de la preparación para estos procesos también se ha adaptado. Existen empresas que ofrecen servicios de “optimización del perfil” para candidatos a universidades de élite, cobrando entre 5.000 y 50.000 dólares por asesoría integral. Estas empresas conocen, por experiencia acumulada o por filtración, qué tipo de actividades extracurriculares, qué vocabulario en los ensayos y qué estructura de expediente tiende a puntuar mejor en cada institución. Acceder a ese conocimiento tiene un precio que no todos pueden pagar. Lo que el algoritmo presenta como meritocracia tiene, debajo, una capa de desigualdad de acceso a la información que los modelos no corrigen, sino que a veces amplifican.
Conviene también considerar el impacto de la inteligencia artificial generativa en este escenario. Desde la llegada de ChatGPT en 2022, las universidades han visto un aumento significativo en ensayos de admisión redactados total o parcialmente con ayuda de IA. Algunas instituciones han respondido eliminando el ensayo de su proceso. Otras han añadido entrevistas presenciales o en vídeo. Varias han invertido en herramientas de detección cuya eficacia sigue siendo objeto de debate. El proceso de admisión, que ya era una carrera de armamentos entre candidatos e instituciones, ha añadido una dimensión nueva que los modelos existentes no estaban preparados para gestionar.
El interés por saber cuánto pueden inferir los algoritmos sobre una persona a partir de señales indirectas es legítimo más allá del entretenimiento: en el contexto educativo, esa inferencia tiene consecuencias directas sobre las oportunidades vitales de alguien.
Algunas universidades han empezado a publicar informes de equidad sobre sus procesos de admisión, desglosando las tasas de aceptación por grupo demográfico. MIT, por ejemplo, publica datos detallados sobre la composición de cada clase. Pero publicar resultados no es lo mismo que abrir el proceso. Se puede saber qué porcentaje de admitidos vino de familias de bajos ingresos sin saber nada sobre cómo funciona el modelo que tomó esas decisiones. La transparencia de resultados no sustituye a la transparencia de criterios.
La regulación está llegando, aunque despacio. La Unión Europea incluye en su Reglamento de Inteligencia Artificial (AI Act), aprobado en 2024, los sistemas de selección educativa entre los de “alto riesgo”, lo que implica requisitos de documentación técnica, evaluación de conformidad y supervisión humana. Cómo se aplicará esto en la práctica a las universidades europeas, muchas de las cuales son públicas pero con alta autonomía institucional, es todavía una pregunta abierta. En Estados Unidos no existe una regulación federal equivalente, aunque varios estados están debatiendo leyes de auditoría algorítmica que podrían afectar a las universidades dentro de su jurisdicción.
El debate sobre los riesgos reales frente a los magnificados de la tecnología es relevante aquí también. Los algoritmos de admisión no son una distopía inevitable, pero tampoco son una solución neutral a un problema complejo. Son herramientas diseñadas por personas, con intereses institucionales detrás, aplicadas a decisiones que cambian vidas. Eso merece más atención pública de la que reciben.
La identidad digital de los candidatos también entra en juego de formas que muchos no anticipan. Como hemos visto al hablar de cómo se construyen y se venden identidades digitales, la frontera entre la persona real y su perfil online es más porosa de lo que parece, y eso tiene implicaciones cuando alguien revisa ese perfil para tomar una decisión que afecta a tu futuro.
¿Seguiremos eligiendo a los estudiantes del mismo modo dentro de diez años?
Probablemente no, aunque la dirección del cambio no está decidida. Las universidades están bajo presión desde dos lados al mismo tiempo: por un lado, la demanda de mayor equidad y transparencia en sus procesos; por otro, la presión para ser más eficientes y gestionar volúmenes de solicitudes que ningún comité humano podría revisar en detalle. Los algoritmos de admisión universitaria son la respuesta al segundo problema, pero no resuelven el primero mientras no estén sujetos a supervisión real.
Lo que el caso de Ofqual en 2020 dejó claro es que cuando un modelo falla de forma visible y masiva, la presión social puede revertirlo en días. El problema es que la mayoría de los sesgos algorítmicos no producen un escándalo visible: producen una acumulación silenciosa de puertas cerradas para personas que nunca sabrán que la decisión la tomó una ecuación, ni con qué variables.
La auditoría independiente, la publicación de los modelos o al menos de sus criterios ponderados, y el derecho real a impugnar una decisión automatizada son condiciones mínimas para que estos sistemas sean aceptables en un contexto democrático. Sin ellas, los algoritmos de admisión universitaria no son más transparentes que el antiguo sistema de contactos y favores que supuestamente vinieron a reemplazar. Solo son más difíciles de señalar con el dedo.
Preguntas frecuentes
¿Qué es un algoritmo de admisión universitaria?
Es un modelo matemático o estadístico que evalúa automáticamente los expedientes de los candidatos asignando pesos distintos a variables como notas, resultados de exámenes, actividades extracurriculares o lugar de procedencia. El modelo genera una puntuación o clasificación que orienta o determina la decisión de admisión, con distinto grado de intervención humana según la institución.
¿Es legal que una universidad use un algoritmo para rechazarme sin que lo revise una persona?
En Europa, el RGPD establece que las decisiones automatizadas con efectos significativos deben poder ser explicadas y recurridas ante un humano. En la práctica, muchas universidades europeas no cumplen este estándar de forma plena. En Estados Unidos no existe una regulación federal equivalente, aunque el AI Act europeo de 2024 clasifica estos sistemas como de alto riesgo y exige supervisión humana.
¿Cómo sé si el algoritmo de mi universidad tiene sesgos?
En la mayoría de los casos, no puedes saberlo directamente. Las universidades rara vez publican los criterios ponderados de sus modelos. Algunas investigaciones independientes, como las del MIT o Cornell, han detectado sesgos analizando los datos de entrada y salida sin acceder al código. La falta de obligación de auditoría externa hace que esta información sea difícil de obtener para un candidato individual.
¿Los algoritmos de admisión universitaria discriminan a estudiantes de familias con menos recursos?
Hay evidencia documentada de que algunos modelos reproducen o amplifican desigualdades socioeconómicas, principalmente a través de variables proxy como el tipo de instituto o la zona de residencia. No todos los modelos tienen este efecto en la misma medida, y algunos sistemas, como el chileno, incluyen correcciones explícitas para compensarlo. Pero sin auditoría independiente, es difícil saberlo institución por institución.
¿Pueden detectar si mi ensayo de admisión lo escribió una IA?
Varias universidades usan herramientas de detección de texto generado por IA, pero su fiabilidad es limitada y está debatida. Estudios de 2023 muestran que estas herramientas generan falsos positivos con más frecuencia en textos escritos por hablantes no nativos del inglés. Algunas universidades han optado por eliminar el ensayo del proceso o añadir entrevistas para compensar estas limitaciones.
¿Qué puedo hacer si creo que un algoritmo me ha rechazado de forma injusta?
En Europa, puedes invocar tu derecho de acceso y el de no ser objeto de decisiones exclusivamente automatizadas bajo el RGPD, y solicitar a la institución una explicación y revisión humana. En países sin esa regulación, las opciones son más limitadas: puedes apelar por los cauces internos de la universidad y, si sospechas discriminación por motivos protegidos, recurrir a las vías legales disponibles en tu jurisdicción.