Las ciudades más avanzadas del mundo ya no solo reaccionan a lo que haces: anticipan lo que vas a hacer. La smart city y la predicción de comportamiento han dejado de ser una promesa de laboratorio para convertirse en infraestructura real, desplegada en calles de Singapur, Barcelona, Dubai o Shanghái. Y la pregunta que importa no es tanto si funciona, sino qué significa que una ciudad sepa —antes que tú— que vas a cruzar en rojo.
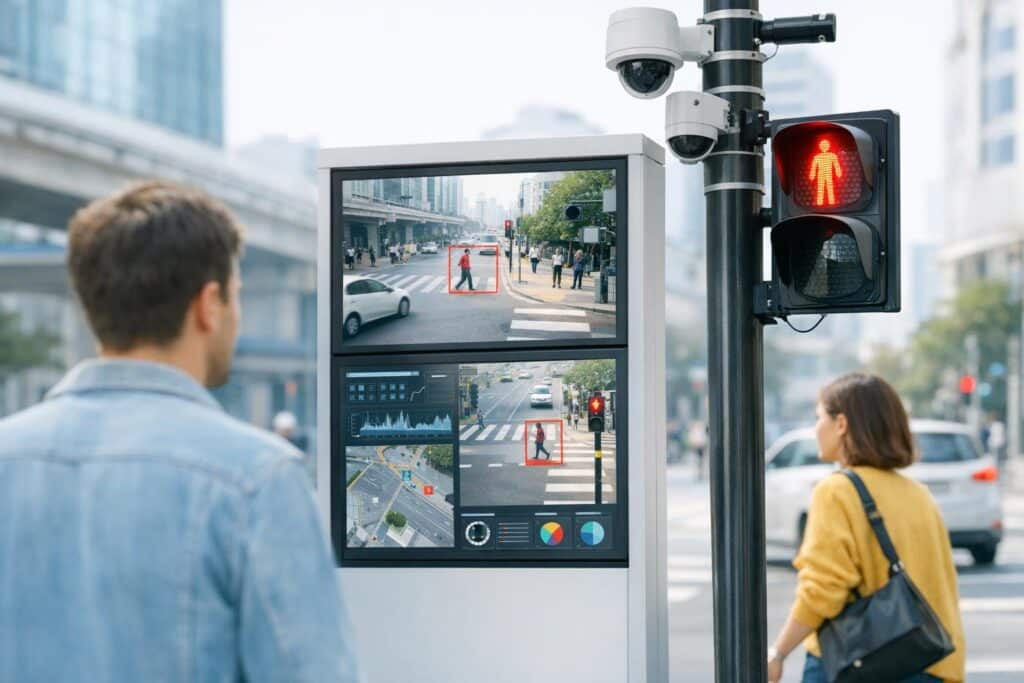
El concepto no es nuevo, pero la escala sí. Durante años, las ciudades instalaron cámaras para registrar lo que ocurría. Ahora, los sistemas de visión artificial, los sensores en el asfalto y los modelos predictivos combinan esos datos para proyectar lo que va a ocurrir en los próximos segundos, minutos u horas. La diferencia entre vigilar y predecir parece técnica. No lo es.
¿Cómo sabe una ciudad lo que vas a hacer antes de que lo hagas?
Los sistemas de predicción de comportamiento en entornos urbanos funcionan mediante la combinación de múltiples fuentes de datos en tiempo real. Las cámaras con visión artificial analizan la trayectoria y la velocidad de los peatones; los sensores de presión en el suelo detectan patrones de pisada; los datos de movilidad de los teléfonos móviles —anonimizados, según las compañías— informan sobre la densidad de personas en una zona. Cruzando todo eso, los algoritmos calculan probabilidades: quién tiene más posibilidades de cruzar antes del verde, qué vehículo frenará tarde, dónde se formará un atasco en veinte minutos.
El caso más documentado es el de Singapur, cuya plataforma Virtual Singapore construye un gemelo digital de la ciudad que integra flujos peatonales, datos de tráfico y predicciones de comportamiento colectivo. El sistema no señala a individuos concretos —al menos, no en su versión pública—, sino que modela el comportamiento de grupos para anticipar situaciones de riesgo o colapso. Algo parecido hace el sistema CityBrain de Alibaba, desplegado en Hangzhou y en varias ciudades de Malasia, que ajusta los semáforos en tiempo real según las predicciones de flujo de tráfico.
En Europa, ciudades como Barcelona y Ámsterdam llevan años acumulando datos de sensores inteligentes en el espacio público. La diferencia con Asia es, sobre todo, regulatoria: el Reglamento General de Protección de Datos de la Unión Europea impone límites más estrictos sobre qué se puede hacer con esa información. Aunque, como ocurre con los datos que persisten más allá de la app, el hecho de que un sistema declare que anonimiza la información no garantiza que no pueda ser reidentificada.
¿Qué tecnologías hay detrás de los semáforos inteligentes?
Los semáforos predictivos ya existen y están en funcionamiento en varias ciudades del mundo. No se trata de semáforos que simplemente cuentan el tiempo: son nodos de una red que recibe, procesa y actúa sobre datos en milisegundos. La tecnología que hace posible todo esto combina varias capas.
La primera es la visión artificial. Cámaras con modelos de deep learning —entrenados con millones de imágenes— identifican peatones, ciclistas y vehículos, y analizan su dirección, velocidad y postura corporal. La postura importa más de lo que parece: un peatón que se inclina hacia delante antes de que el semáforo cambie, que mira el teléfono mientras camina hacia la calzada o que reduce el paso al acercarse al bordillo genera señales distintas que el algoritmo aprende a interpretar.
La segunda capa es la conectividad V2X (vehicle-to-everything), que permite que los vehículos, los semáforos y la infraestructura urbana se comuniquen entre sí. Un coche autónomo o semiautónomo puede recibir una alerta del semáforo antes de que este cambie a rojo; el semáforo, a su vez, puede alargar la fase verde si detecta que un autobús lleva retraso o que hay un peatón de movilidad reducida cruzando.
La tercera es el procesamiento en el borde (edge computing): en vez de enviar todos los datos a un servidor central, el análisis ocurre directamente en el dispositivo o muy cerca de él. Esto reduce la latencia a milisegundos, lo cual es imprescindible cuando el margen entre una predicción útil y una predicción inútil es de décimos de segundo. Y tiene otra consecuencia relevante: los datos pueden no salir nunca del semáforo, lo que complica saber qué se captura realmente.
Todo esto encaja con una tendencia más amplia que ya se está viendo en cómo las ciudades inteligentes se acercan a la vigilancia sin que la mayoría de sus habitantes lo perciban como tal.
¿Puede un algoritmo predecir comportamientos peligrosos en la calle?
Los sistemas actuales pueden predecir comportamientos de riesgo con una precisión estadística notable, aunque los fabricantes tienden a sobreestimar esa precisión en sus materiales comerciales. Lo que los algoritmos hacen bien es detectar patrones colectivos: horas punta con mayor tasa de infracciones, zonas donde los peatones cruzan sistemáticamente fuera del paso, tramos donde los coches superan el límite de velocidad de forma recurrente. Lo que hacen peor es predecir comportamientos individuales e impredecibles.
La empresa estadounidense Miovision, uno de los proveedores más extendidos de analítica de tráfico por visión artificial, ofrece sistemas que detectan «comportamientos anómalos» en intersecciones y generan alertas preventivas. Genetec, empresa canadiense con presencia en decenas de ciudades europeas, combina cámaras, sensores y análisis predictivo para anticipar incidentes antes de que ocurran. Ninguna de estas empresas afirma que sus sistemas identifiquen a personas concretas en tiempo real —al menos no en sus mercados europeos—, pero la línea entre análisis de comportamiento y identificación personal es técnicamente muy fina.
El problema más documentado con los sistemas de predicción de comportamiento no es el fallo técnico, sino el sesgo. Los modelos de visión artificial entrenados con datos históricos replican los sesgos de esos datos: si una zona de la ciudad estaba sobrerrepresentada en registros de incidentes, el algoritmo la marcará como zona de riesgo con mayor frecuencia, independientemente de la realidad actual. Es el mismo problema que afecta a los algoritmos de predicción climática urbana: la calidad del modelo depende de la calidad —y la imparcialidad— de los datos con los que fue entrenado.
¿Qué pasa con tus datos cuando la ciudad te observa?
La respuesta honesta es que depende de dónde vivas, y que en muchos casos no lo sabes con certeza. En la Unión Europea, el RGPD y la Ley de Inteligencia Artificial —aprobada en 2024— establecen límites claros sobre el uso de sistemas de identificación biométrica en espacios públicos. La identificación facial en tiempo real está, en principio, prohibida salvo excepciones muy tasadas. Pero los sistemas de análisis de comportamiento que no identifican a personas concretas —o que afirman no hacerlo— operan en una zona gris regulatoria que todavía está siendo definida.
Fuera de Europa, el panorama es radicalmente diferente. En China, la integración entre cámaras de reconocimiento facial, bases de datos gubernamentales y sistemas de puntuación social está documentada y reconocida oficialmente. En Estados Unidos, la regulación varía por estado: algunas ciudades como San Francisco han prohibido el reconocimiento facial municipal; otras lo utilizan con escasa transparencia. En los países del Golfo, donde ciudades como Dubai están construyendo infraestructuras de ciudad inteligente desde cero, la privacidad del ciudadano no es el criterio de diseño prioritario.
Un aspecto que rara vez se menciona en los comunicados de las smart cities es quién gestiona los datos recogidos y bajo qué contrato. En muchos casos, la infraestructura es propiedad de una empresa privada —Siemens, Huawei, Cisco, IBM— que la cede o alquila al municipio. Los datos que esa infraestructura genera pueden estar sujetos a las políticas de privacidad de la empresa, no solo a la legislación local. Y como ya hemos visto en contextos distintos, la propiedad real de los datos raramente es del usuario que los genera.
Hay además un efecto secundario que los estudios de urbanismo empiezan a documentar: el cambio de comportamiento inducido por la conciencia de ser observado. El efecto Hawthorne —la tendencia de las personas a modificar su conducta cuando saben que están siendo monitorizadas— no desaparece porque el observador sea un algoritmo. Puede que cruces en rojo menos veces. Pero también puede que empieces a evitar ciertas calles, ciertas horas, ciertos barrios. La ciudad predice tu comportamiento y, al hacerlo, lo altera. Es un bucle que todavía no sabemos cómo medir bien.
Esta dinámica tiene mucho en común con cómo funciona el mercado que captura tu atención en entornos digitales: en ambos casos, el sistema aprende de ti para influir en ti, y el bucle es invisible para quien lo vive desde dentro.
¿Quién decide qué comportamientos son «normales» en una ciudad inteligente?
Esta es la pregunta que los fabricantes de tecnología para smart cities raramente responden en sus folletos. Cualquier sistema de detección de comportamiento anómalo necesita una definición de lo que es normal. Y esa definición no es neutral: es una decisión política, cultural y, en última instancia, de poder. Definir qué es una anomalía en el espacio público es definir quién encaja en él y quién no.
Los sistemas de predicción entrenados con datos históricos tienden a reproducir la norma estadística predominante. Si en una ciudad determinada los peatones cruzan mayoritariamente en el paso de cebra y esperan el verde, el algoritmo aprenderá que quien no lo hace es una anomalía. Pero en ciudades donde cruzar en rojo es culturalmente habitual —como ocurre en muchas ciudades latinoamericanas o del sur de Europa—, el mismo sistema generará una tasa de alertas artificialmente inflada que no refleja peligro real, sino diferencia cultural.
Hay también una dimensión de clase y racialización que los estudios críticos sobre tecnología urbana vienen documentando desde hace años. Los sistemas de vigilancia predictiva no se despliegan de forma homogénea por la ciudad: tienden a concentrarse en barrios con mayor densidad de población vulnerable, lo que refuerza la sobreexposición de esas comunidades a la supervisión algorítmica. El sesgo no está solo en el modelo: está en dónde se instalan las cámaras.
Nada de esto significa que los sistemas de gestión inteligente del tráfico no puedan salvar vidas. Pueden hacerlo, y en algunos contextos lo hacen. Pero la eficiencia técnica y la justicia en el diseño son dos variables distintas, y optimizar una no garantiza avanzar en la otra. La misma infraestructura que reduce los accidentes en una intersección puede, si se diseña mal o se gestiona sin transparencia, convertirse en un mecanismo de control del espacio público con consecuencias que van mucho más allá del tráfico.
La tokenización de espacios urbanos y la gestión algorítmica del bien común comparten un problema estructural que también aparece en debates sobre quién controla realmente los activos digitales: la tecnología puede redistribuir el poder o concentrarlo, dependiendo de quién la diseña y para quién.
¿Y si la ciudad que nos predice no rinde cuentas a nadie?
La promesa de la smart city y la predicción de comportamiento es seductora: menos accidentes, tráfico más fluido, emergencias resueltas antes de que ocurran. Y esa promesa no es completamente falsa. Los sistemas de semáforos adaptativos reducen los tiempos de espera. Los modelos predictivos de accidentes de tráfico tienen una base estadística sólida. La tecnología, en este caso, funciona.
El problema es la gobernanza. Una ciudad que anticipa comportamientos necesita mecanismos igualmente sofisticados para responder preguntas básicas: ¿Qué datos se recogen exactamente? ¿Quién los guarda y durante cuánto tiempo? ¿Qué decisiones toma el algoritmo de forma autónoma y cuáles requieren supervisión humana? ¿Puede un ciudadano impugnar una decisión que le afecte y que fue tomada por un sistema automático? En la mayoría de las ciudades que hoy despliegan estos sistemas, esas preguntas no tienen respuesta pública.
La infraestructura digital que subyace a todo esto también tiene un coste ambiental que conviene no ignorar. Los centros de datos que procesan los flujos de información de las ciudades inteligentes consumen cantidades ingentes de energía, y la promesa de eficiencia urbana no siempre compensa la huella que genera. Es una contradicción que ya hemos explorado al hablar del consumo energético oculto de la industria tecnológica.
Quizás la pregunta más inquietante no es si la ciudad puede predecir que vas a cruzar en rojo. Es si una ciudad que te predice con esa precisión puede seguir siendo, en algún sentido significativo, un espacio de libertad. Y si la respuesta a esa pregunta la debemos dar nosotros —los ciudadanos— antes de que la den los algoritmos por nosotros.
Preguntas frecuentes
¿Qué es una smart city de predicción de comportamiento?
Una smart city con predicción de comportamiento es una ciudad que utiliza sensores, cámaras con inteligencia artificial y modelos algorítmicos para anticipar lo que harán peatones y conductores antes de que ocurra. No solo registra lo que pasa, sino que calcula probabilidades de acciones futuras en segundos o minutos, y actúa sobre la infraestructura —semáforos, alertas, flujos de tráfico— en consecuencia.
¿Los semáforos inteligentes realmente me están observando a mí?
Los sistemas más extendidos analizan comportamientos colectivos, no individuos concretos, aunque la distinción técnica es más frágil de lo que parece. En Europa, la identificación biométrica en tiempo real está en gran medida prohibida por la Ley de Inteligencia Artificial de 2024. En otras jurisdicciones, la regulación es mucho más laxa o directamente inexistente.
¿Son fiables las predicciones de los algoritmos de tráfico urbano?
Son estadísticamente útiles para predecir comportamientos colectivos y patrones recurrentes, pero fallan con más frecuencia en comportamientos individuales e impredecibles. El problema más documentado no es la imprecisión técnica, sino el sesgo: los modelos entrenados con datos históricos tienden a reproducir las desigualdades de esos datos, marcando como «zonas de riesgo» a menudo los mismos barrios que ya estaban sobrerrepresentados en los registros anteriores.
¿Mis datos están seguros cuando una ciudad inteligente me monitoriza?
Depende fundamentalmente de dónde vivas y de quién gestiona la infraestructura. En la Unión Europea existen garantías legales, pero los contratos entre municipios y empresas tecnológicas privadas no siempre son públicos, y los datos pueden quedar sujetos a las políticas de esas empresas. Fuera de Europa, las protecciones son muy variables y en muchos países prácticamente inexistentes.
¿Pueden estos sistemas discriminar a ciertos grupos de personas?
Sí, y hay estudios que lo documentan. Los sistemas de vigilancia predictiva suelen desplegarse de forma desigual por la ciudad, concentrándose en barrios con mayor densidad de población vulnerable. Además, los modelos de visión artificial entrenados con datos históricos pueden tener peor rendimiento con personas de determinadas características étnicas o formas de moverse que estaban infrarrepresentadas en los datos de entrenamiento.
¿Puedo saber si mi ciudad me está monitorizando con IA?
En teoría, los ayuntamientos están obligados a informar sobre el uso de sistemas de vigilancia en el espacio público, especialmente en Europa. En la práctica, la información disponible suele ser escasa, técnica y difícil de encontrar. Organizaciones como Access Now o el European Digital Rights Network (EDRi) publican informes periódicos sobre el despliegue de estas tecnologías en ciudades europeas.