El edge computing es la apuesta tecnológica que más puede cambiar la forma en que usamos internet en la próxima década, y sin embargo casi nadie habla de ella fuera de los círculos de ingeniería. La idea central es tan simple como radical: en lugar de enviar todos tus datos a un servidor lejano para que los procese y te devuelva la respuesta, el procesamiento ocurre directamente en tu dispositivo, o en uno muy cercano a ti. El edge computing y su futuro tienen menos que ver con la ciencia ficción y más con una limitación física concreta: la velocidad de la luz no es infinita, y mover datos tiene un coste.
Hasta hace poco, la narrativa dominante en tecnología era clara: todo a la nube. Más potencia, más escalabilidad, más comodidad para las empresas. Pero esa narrativa tiene grietas. Grietas que cada vez son más difíciles de ignorar cuando hablamos de coches autónomos, cirugía remota o sistemas industriales que no pueden permitirse ni un segundo de latencia.
¿Qué es el edge computing y en qué se diferencia de la nube?
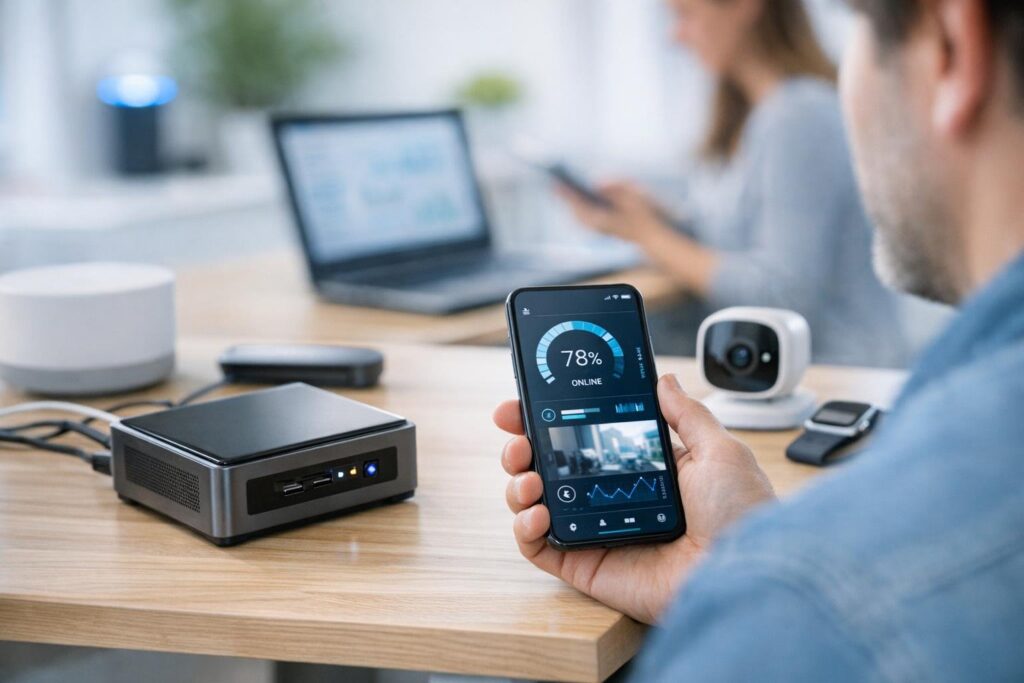
El edge computing es un modelo de procesamiento distribuido en el que los datos se analizan cerca de donde se generan, no en centros de datos remotos. Mientras que la computación en la nube centraliza todo el trabajo en grandes servidores —propiedad de empresas como Amazon Web Services, Microsoft Azure o Google Cloud—, el edge computing descentraliza ese trabajo y lo lleva al «borde» de la red: tu teléfono, un router inteligente, una cámara de seguridad o un sensor industrial.
La diferencia no es solo técnica. Es una diferencia de filosofía. La nube asume que siempre habrá conexión estable y suficiente ancho de banda. El edge computing asume que la conexión puede fallar, que los datos sensibles no deberían viajar más de lo necesario, y que algunas decisiones no pueden esperar el tiempo que tarda un paquete de datos en ir y volver a un servidor en otro continente.
Un ejemplo concreto: un coche autónomo genera entre 1 y 5 terabytes de datos por hora de conducción. Enviar todo eso a la nube para que decida si hay un peatón en el cruce es, literalmente, inviable. La decisión tiene que tomarse en milisegundos, y tiene que tomarse a bordo del vehículo.
¿Por qué el edge computing importa ahora mismo, no en el futuro?
El edge computing ya está activo y afectando tu vida cotidiana, aunque no lo veas. Los modelos de lenguaje que funcionan directamente en tu teléfono sin conexión, los altavoces inteligentes que procesan comandos de voz localmente antes de enviar nada, los sistemas de reconocimiento facial en aeropuertos que no pueden depender de una conexión a internet: todos son ejemplos de computación en el borde aplicada hoy.
Apple lleva años integrando chips de procesamiento de señal y motores de IA directamente en sus dispositivos —primero con los chips A-series y ahora con los M-series— precisamente para reducir la dependencia de servidores externos en tareas como el reconocimiento de texto en fotos, la detección de caídas o el procesamiento de audio. Qualcomm y MediaTek siguen la misma lógica con sus procesadores para Android. El resultado es que tu dispositivo hace mucho más de lo que crees sin salir de tu bolsillo.
Pero el impacto más profundo del edge computing no está en el consumidor individual, sino en la industria. Las fábricas inteligentes —lo que se llama Industria 4.0— dependen de sensores que toman decisiones en tiempo real sobre líneas de producción. Un fallo de conexión no puede detener una cadena de montaje. En ese contexto, las decisiones automatizadas sin supervisión humana directa plantean preguntas que van mucho más allá de la ingeniería.
La sanidad es otro terreno donde el edge computing está dejando de ser experimental. Los dispositivos de monitorización cardíaca, los marcapasos inteligentes o los sistemas de alerta temprana para personas mayores no pueden depender de la cobertura 4G para saber si algo va mal. Tienen que procesar la señal localmente y actuar de inmediato.
¿El edge computing es más seguro que la nube?
El edge computing reduce ciertos riesgos de seguridad, pero crea otros nuevos que no conviene ignorar. El argumento a favor es intuitivo: si tus datos médicos o biométricos no viajan a un servidor central, hay menos superficie de ataque. Una brecha en un servidor de Amazon Web Services puede exponer los datos de millones de usuarios a la vez. Una brecha en un dispositivo local afecta, en principio, solo a ese dispositivo.
Pero la realidad es más compleja. Una red de miles de dispositivos edge —cámaras, sensores, routers— es una superficie de ataque enorme y descentralizada, mucho más difícil de monitorizar y parchear que unos pocos centros de datos bien custodiados. Cada nodo del borde es una puerta de entrada potencial. Y los fabricantes de dispositivos de consumo tienen un historial poco glorioso en materia de actualizaciones de seguridad.
Los sistemas de vigilancia basados en edge computing —cámaras que procesan imágenes localmente para identificar personas o comportamientos— plantean además un problema de privacidad diferente al de la nube. No es que tus datos viajen a un servidor de una empresa. Es que hay un dispositivo físico cerca de ti que te analiza constantemente sin que los datos salgan a ningún sitio auditable. Eso tiene implicaciones para la vigilancia masiva que merecen un debate mucho más abierto del que estamos teniendo.
¿Qué papel juega la inteligencia artificial en el edge computing?
La inteligencia artificial y el edge computing están convergiendo de una manera que va a redefinir lo que entendemos por dispositivo «inteligente». Ejecutar modelos de IA directamente en hardware local —lo que se conoce como inferencia en el borde— era técnicamente imposible hace cinco años para la mayoría de aplicaciones. Hoy, gracias a técnicas de compresión de modelos como la cuantización y el pruning, es una realidad comercial.
Empresas como NVIDIA con su plataforma Jetson, Google con sus chips Tensor Processing Unit en versión embebida, o las startups especializadas en IA de bajo consumo como Hailo y Syntiant, están construyendo hardware diseñado específicamente para ejecutar modelos de IA sin necesidad de internet. El objetivo es que el dispositivo pueda ver, escuchar, analizar y decidir por sí solo.
Esto tiene consecuencias directas en cómo entendemos la privacidad. Un asistente de voz que procesa tu petición completamente en local —como el modo de privacidad de algunos dispositivos Sonos o las últimas versiones de Siri en iPhone con funciones Apple Intelligence— nunca envía tu voz a ningún servidor. Nadie puede acceder a esa conversación porque nunca sale del dispositivo. Pero eso también significa que si el modelo local comete un error, no hay forma fácil de auditarlo ni corregirlo de forma centralizada.
La convergencia entre IA y edge computing también está acelerando el debate sobre qué tipo de decisiones pueden delegar los humanos en máquinas autónomas. Cuando un algoritmo decide en tiempo real sin intervención humana y sin registrar su razonamiento en ningún servidor central, ¿quién responde si se equivoca?
¿Cómo afecta el edge computing al consumo energético y al medioambiente?
El edge computing puede reducir el consumo energético global de internet, pero no de forma automática ni garantizada. El argumento optimista: transmitir menos datos a la nube significa menos tráfico de red, lo que reduce el consumo de los routers, switches y cables de fibra óptica que sostienen internet. Los centros de datos, que ya consumen alrededor del 1-2% de la electricidad mundial según la Agencia Internacional de la Energía, necesitarían procesar menos si parte del trabajo se hace en local.
El argumento pesimista: multiplicar por millones los dispositivos con capacidad de procesamiento local significa fabricar más chips, más hardware especializado, más baterías. El coste ambiental de fabricar silicio es enorme, y la promesa de eficiencia energética puede quedar sepultada bajo una avalancha de nuevos aparatos con obsolescencia programada.
El impacto real dependerá de si la industria tecnológica adopta el edge computing como una herramienta de eficiencia genuina o como excusa para vender más hardware. El historial no invita al optimismo sin matices. Los modelos de lenguaje más grandes, que consumen cantidades masivas de energía en su entrenamiento, siguen creciendo en paralelo al edge computing, no en sustitución de él.
¿Y el 5G? ¿No resolvía ya el problema de la latencia?
El 5G mejora la velocidad y la latencia de las redes móviles, pero no elimina la necesidad del edge computing: en realidad, los dos se complementan. El 5G hace más viable el edge computing distribuido al permitir que los dispositivos del borde se comuniquen entre sí con muy baja latencia. Pero incluso con 5G, enviar datos a un servidor al otro lado del mundo sigue siendo más lento que procesarlos localmente.
Además, el 5G tiene sus propias limitaciones. La cobertura sigue siendo desigual, especialmente en zonas rurales. Las ondas milimétricas de alta frecuencia que dan las velocidades más impresionantes tienen un alcance muy corto y son bloqueadas por paredes y obstáculos. En la práctica, muchos de los casos de uso más críticos —hospitales, fábricas, túneles, zonas remotas— no pueden depender de una red de telecomunicaciones que no controlan.
El edge computing es, en ese sentido, también una apuesta por la resiliencia. Un sistema que funciona aunque la red falle es un sistema más robusto. Y en un mundo donde los ataques a infraestructuras críticas son cada vez más frecuentes, esa resiliencia tiene un valor que va más allá de los milisegundos de latencia. La idea de que nuestros sistemas sanitarios, industriales y de transporte dependan de servidores remotos que otros controlan debería incomodarnos más de lo que lo hace.
¿Estamos preparados para un mundo donde los dispositivos deciden solos?
El edge computing no es solo una solución técnica a un problema de latencia. Es el primer paso hacia un ecosistema en el que millones de dispositivos toman decisiones autónomas en tiempo real, sin pasar por ningún servidor centralizado, sin que ningún humano las revise antes de ejecutarlas. Eso tiene implicaciones que la industria tecnológica está tardando mucho en discutir con la misma urgencia con la que desarrolla el hardware.
¿Quién audita un modelo de IA que solo existe en un dispositivo local? ¿Cómo se corrige un error sistemático en millones de dispositivos distribuidos si no hay un servidor central que actualizar? ¿Qué pasa cuando el dispositivo edge que toma decisiones sobre tu salud o tu seguridad vial deja de recibir actualizaciones porque el fabricante lo ha discontinuado?
Estas no son preguntas teóricas. Son las preguntas que deberíamos estar haciendo ahora, mientras el edge computing pasa de ser una promesa de ingeniería a convertirse en la infraestructura invisible que sostiene partes críticas de nuestra vida. El futuro quizás no está en la nube. Pero tampoco está garantizado porque el procesamiento ocurra más cerca de nosotros. La proximidad física de los datos no resuelve los errores que cometen los modelos que los procesan, ni las preguntas sobre quién responde cuando algo falla.
La computación en el borde promete un internet más rápido, más privado y más resiliente. Puede cumplir esa promesa. Pero solo si construimos, en paralelo, los marcos legales, los estándares de auditoría y la cultura de responsabilidad que hagan que descentralizar el poder de procesamiento no signifique, de paso, descentralizar también la responsabilidad hasta hacerla invisible. Porque lo que no tiene un responsable claro tampoco tiene una forma clara de mejorarse cuando falla.
¿Queremos realmente que nuestros dispositivos piensen por nosotros sin dar explicaciones?
El edge computing nos acerca a una paradoja curiosa: cuanto más capaces son nuestros dispositivos de actuar solos, más difícil es entender qué están haciendo y por qué. La promesa es comodidad, velocidad y privacidad. El riesgo es que estemos construyendo una capa de inteligencia distribuida opaca por diseño, no por negligencia. Igual que ocurre con la IA generativa, las metáforas que usamos para describir estos sistemas pueden oscurecer más de lo que iluminan.
La pregunta que debería acompañar cada avance en computación en el borde no es solo «¿funciona?» sino «¿podemos entenderlo, corregirlo y responsabilizarnos de ello cuando no funciona?». Porque si la respuesta a esas tres preguntas es no, estamos delegando decisiones en sistemas que no rinden cuentas a nadie. Y eso, con independencia de dónde ocurra el procesamiento, es el problema más antiguo de la tecnología con el poder.
Preguntas frecuentes
¿Qué es el edge computing en términos sencillos?
El edge computing es un modelo tecnológico en el que los datos se procesan en el propio dispositivo o muy cerca de él, en lugar de enviarse a servidores remotos en la nube. El objetivo es reducir el tiempo de respuesta, disminuir el consumo de ancho de banda y mejorar la privacidad, especialmente en aplicaciones donde cada milisegundo cuenta, como vehículos autónomos o dispositivos médicos.
¿El edge computing reemplazará a la nube?
El edge computing no sustituirá a la nube, sino que la complementará. Las tareas que requieren gran capacidad de almacenamiento, aprendizaje a partir de grandes volúmenes de datos o colaboración entre sistemas seguirán necesitando servidores centralizados. El edge computing se especializará en las decisiones que no pueden esperar: las que necesitan respuesta inmediata y no toleran cortes de conexión.
¿Es el edge computing más privado que usar aplicaciones en la nube?
Depende de cómo se implemente. Cuando el procesamiento ocurre completamente en local y los datos no se transmiten, la privacidad mejora porque no hay servidor externo que pueda ser hackeado o que comparta tu información. Pero una red de dispositivos edge distribuidos también crea nuevos riesgos: cada dispositivo es un punto de vulnerabilidad, y muchos fabricantes tienen un historial deficiente en actualizaciones de seguridad.
¿Qué dispositivos que ya uso funcionan con edge computing?
Probablemente más de los que crees. Los iPhone modernos procesan localmente el reconocimiento facial, la detección de texto en fotos y algunas funciones de Siri. Los altavoces inteligentes detectan la palabra de activación sin enviar audio a ningún servidor. Las cámaras de seguridad con análisis de movimiento local y los smartwatches con monitorización cardíaca son también ejemplos cotidianos de computación en el borde.
¿Qué riesgos tiene que los dispositivos tomen decisiones sin conexión a internet?
El principal riesgo es la falta de supervisión y actualización. Un dispositivo que decide de forma autónoma sin registrar esas decisiones en ningún servidor central es muy difícil de auditar si comete errores sistemáticos. Además, si el fabricante deja de dar soporte al dispositivo, el modelo de IA integrado puede quedar desactualizado e inservible, pero seguir funcionando con criterios obsoletos sin que nadie lo detecte.
¿Cómo afecta el edge computing al medioambiente?
El impacto ambiental del edge computing es ambivalente. Por un lado, reduce el tráfico de datos y puede aliviar la carga energética de los grandes centros de datos. Por otro, multiplicar los dispositivos con capacidad de procesamiento local implica fabricar más chips y hardware especializado, con un coste ambiental significativo. Si se convierte en excusa para vender más aparatos, el balance ecológico podría ser negativo.


