Los sistemas de IA multimodal ya pueden recibir una imagen, escuchar lo que dices sobre ella y responderte con voz, texto o código, todo en el mismo instante. Las capacidades multimodales de la IA no son una promesa de laboratorio: GPT-4o, Gemini 1.5 Pro y Claude 3 Opus llevan meses procesando combinaciones de texto, audio, imagen y vídeo que hace dos años resultaban imposibles para cualquier modelo comercial. Lo que cambia con esto no es solo la velocidad. Es la forma en que las máquinas construyen su comprensión del mundo.
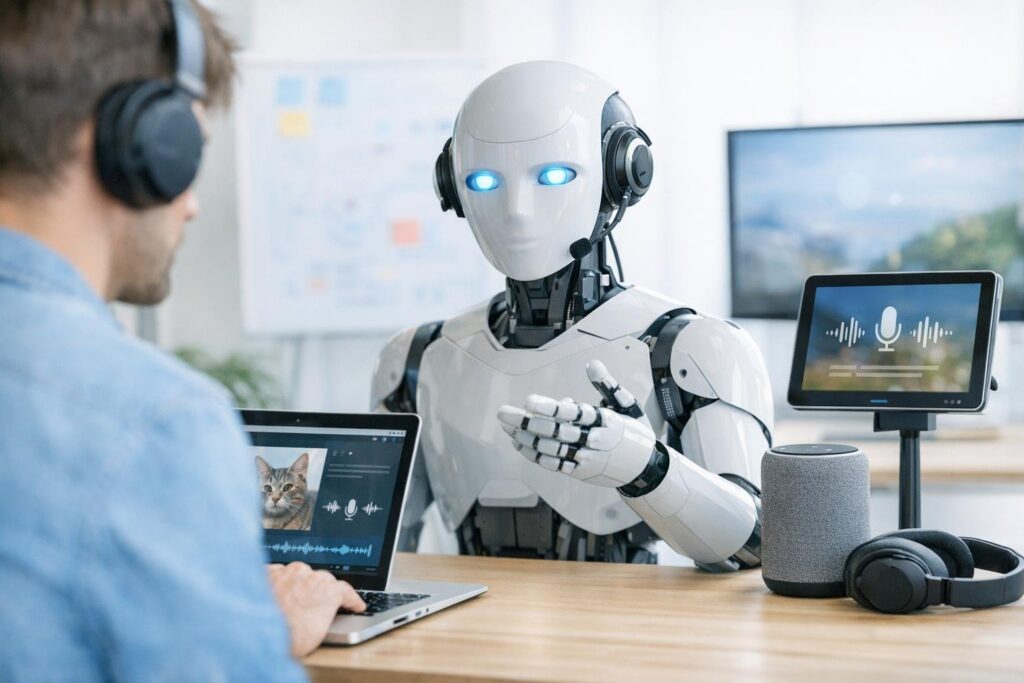
Durante años, los modelos de lenguaje vivieron en una sola dimensión. Leían texto, generaban texto. Punto. Los modelos de visión procesaban imágenes pero no podían conversar sobre ellas. Los sistemas de voz transcribían audio pero no razonaban sobre su contenido. Cada modalidad era un silo separado, con sus propios pesos, su propio entrenamiento, su propia lógica interna. La arquitectura multimodal rompe esos silos y los une en un único modelo que procesa señales heterogéneas de forma simultánea, no secuencial.
¿Qué significa realmente que una IA sea multimodal?
Una IA multimodal es aquella que puede procesar y relacionar al mismo tiempo distintos tipos de información: texto, imágenes, audio, vídeo y, en algunos casos, datos estructurados o código. El matiz importante está en “relacionar”. No basta con que el modelo reciba varios formatos: lo definitivo es que construya representaciones conjuntas, que lo que ve influya en cómo interpreta lo que oye, y viceversa.
La arquitectura técnica detrás de esto se apoya en los llamados encoders especializados por modalidad que convierten cada tipo de entrada en vectores numéricos, y en capas de fusión que integran esas representaciones antes de que el modelo genere su respuesta. GPT-4o, presentado por OpenAI en mayo de 2024, fue el primer modelo en hacer esta integración de forma nativa para texto, imagen y audio sin depender de módulos separados encadenados. Antes, productos como el ChatGPT con capacidades de visión simplemente pasaban la imagen por un modelo de visión auxiliar y concatenaban el resultado. No es lo mismo.
Esta diferencia arquitectónica tiene consecuencias reales. Un modelo con fusión nativa puede, por ejemplo, detectar el tono emocional de una voz y ajustar la interpretación de las palabras que se dicen en función de ese tono. Algo que los modelos encadenados no podían hacer bien porque la información emocional se perdía en la transferencia entre módulos. La arquitectura interna de los modelos de lenguaje condiciona profundamente lo que el modelo puede o no puede percibir.
¿Qué pueden hacer hoy GPT-4o, Gemini y los demás que antes era imposible?
Los modelos multimodales actuales realizan tareas que hasta 2023 requerían pipelines completos de varios sistemas especializados. Gemini 1.5 Pro, lanzado por Google DeepMind a principios de 2024, puede analizar un vídeo de una hora completa, identificar momentos específicos, responder preguntas sobre lo que ocurre en escenas concretas y cruzar esa información con texto externo. Su ventana de contexto de hasta un millón de tokens le permite procesar libros enteros, películas largas o repositorios de código de tamaño considerable sin fragmentarlos.
GPT-4o, por su parte, introdujo la interacción por voz con latencia baja real, en torno a 320 milisegundos de media según los datos publicados por OpenAI, lo que lo sitúa cerca del tiempo de respuesta humano en una conversación. Esa latencia baja cambia la experiencia de forma cualitativa: ya no parece que esperas a que una máquina procese, parece que hablas con alguien. El efecto psicológico es distinto, y eso tiene implicaciones que van más allá de la comodidad.
Claude 3 Opus, de Anthropic, destaca en el análisis de documentos complejos que combinan texto e imágenes, como informes financieros con gráficos, manuales técnicos con diagramas o artículos científicos con figuras. La capacidad de razonar sobre la relación entre un gráfico y el texto que lo comenta, en vez de analizarlos por separado, mejora significativamente la calidad de las respuestas en contextos profesionales.
En el terreno médico, la IA multimodal empieza a mostrar resultados que merecen atención, aunque también precaución. Modelos especializados como Med-Gemini pueden cruzar imágenes de diagnóstico, historial clínico en texto y resultados de laboratorio para sugerir interpretaciones que un especialista tendría que sopesar. El riesgo de errores en diagnósticos asistidos por IA se hace más complejo cuando el modelo maneja simultáneamente varias fuentes de datos, porque un fallo en la fusión puede ser más difícil de detectar que un error en un sistema monomodal.
¿Cómo afectan estas capacidades a lo que hacemos cada día?
Las aplicaciones más inmediatas de la IA multimodal llegan a través de interfaces que ya usamos. Google Lens integra modelos de visión con búsqueda textual desde hace tiempo, pero la versión actual de Google Search con funciones multimodales permite hacer preguntas verbales sobre lo que la cámara enfoca y recibir respuestas elaboradas. Apple Intelligence, presentada en la WWDC 2024, lleva capacidades multimodales directamente al sistema operativo: el iPhone puede entender una notificación, una imagen recibida y el contexto de la conversación al mismo tiempo para sugerir acciones.
En educación, herramientas como Khan Academy con Khanmigo ya utilizan capacidades multimodales para analizar los ejercicios manuscritos que un estudiante fotografía, identificar el tipo de error cometido y ofrecer una explicación adaptada. El modelo no solo lee el resultado final: interpreta el proceso visible en el papel. Eso supone una diferencia pedagógica real frente a corregir solo la respuesta.
La creatividad también se ve afectada. Modelos como Sora, de OpenAI, generan vídeo a partir de texto. Runway Gen-3 y Kling permiten extender, editar o transformar vídeos existentes con instrucciones en lenguaje natural. La combinación de generación de imagen, audio y vídeo en flujos de trabajo creativos plantea preguntas sobre qué queda de la autoría humana cuando una máquina puede ejecutar casi cualquier instrucción estética.
En accesibilidad, el impacto es concreto y positivo sin matices: modelos multimodales que describen imágenes con precisión, transcriben audio con identificación de hablantes o traducen lenguaje de signos en tiempo real representan mejoras reales para millones de personas. Este es uno de los usos donde las capacidades de la IA multimodal generan beneficio sin controversia significativa.
¿Qué no pueden hacer todavía estos modelos?
Los modelos multimodales actuales tienen limitaciones importantes que conviene no perder de vista. La comprensión espacial profunda, es decir, razonar sobre relaciones tridimensionales a partir de imágenes planas, sigue siendo débil. Los modelos confunden con frecuencia la posición relativa de objetos en una escena, especialmente cuando la perspectiva es inusual. Los benchmarks de razonamiento espacial como SpatialBench muestran que incluso GPT-4o comete errores que un niño de diez años no cometería.
El audio no verbal también presenta problemas. Estos sistemas reconocen emociones básicas con una fiabilidad razonable, pero fallan ante ironía sutil, cambios de tono dentro de una misma frase o señales culturalmente específicas. El riesgo es que el usuario asuma que el modelo “entiende” el contexto emocional cuando en realidad está haciendo inferencias estadísticas sobre patrones de entrenamiento.
La consistencia entre modalidades tampoco está resuelta. Un modelo puede describir correctamente una imagen en texto pero generar una imagen completamente distinta a partir de esa misma descripción. La representación interna de “un gato sentado sobre una silla de madera” no es simétrica entre el encoder de visión y el decoder de imagen. Esto tiene implicaciones en casos de uso donde la precisión importa, como documentación técnica o diseño asistido.
Conviene recordar también que, como ocurre con cualquier sistema de IA, la brecha entre lo que los modelos multimodales prometen en demos y lo que entregan en producción real merece un análisis propio. Las demos de lanzamiento siempre muestran los mejores casos.
El peso del entrenamiento: de dónde viene lo que estos modelos “saben” ver
Los modelos multimodales aprenden a relacionar modalidades a partir de conjuntos de datos masivos que emparejan imágenes con descripciones, vídeos con subtítulos, audio con transcripciones. LAION-5B, uno de los datasets de imagen y texto más usados en el entrenamiento de modelos de visión, contiene más de cinco mil millones de pares imagen-texto extraídos de internet. La calidad, los sesgos y los derechos de ese material no son neutrales.
Un modelo entrenado principalmente con imágenes de internet hereda los sesgos de representación de internet: sobrerepresenta ciertas etnias, estilos visuales, contextos geográficos y convenciones culturales, y subrepresenta otros. Cuando ese modelo se usa para tomar decisiones que afectan a personas reales, los sesgos visuales se convierten en sesgos de resultado. No es una hipótesis: hay documentación de casos en reconocimiento facial, análisis de expresiones y clasificación de imágenes médicas.
El sesgo en modelos multimodales es más difícil de auditar que en modelos de texto, porque interactúa entre modalidades de formas que no siempre son predecibles. Un sesgo en la representación visual puede amplificarse o atenuarse al combinarse con el texto, y los métodos de auditoría estándar no están adaptados todavía a ese nivel de complejidad.
La cuestión de los datos de entrenamiento también tiene una dimensión legal activa. En 2024, varios artistas y fotógrafos presentaron demandas contra Stability AI, Midjourney y otros proveedores por el uso de obras con copyright en el entrenamiento de modelos de imagen. El debate sobre si el entrenamiento constituye uso derivado protegido o no está lejos de resolverse, y su resultado afectará directamente a cómo se entrenen los próximos modelos multimodales.
¿Hacia dónde llevan estas capacidades cuando los modelos empiecen a actuar, no solo a responder?
La combinación de capacidades multimodales con agencia, es decir, con la capacidad de ejecutar acciones en el mundo real, abre una dimensión diferente. Un modelo que ve tu pantalla, escucha tus instrucciones y puede hacer clic, escribir y navegar por ti no es solo un asistente más capaz. Es un actor con acceso a tus herramientas. Los agentes de IA autónomos que ya empiezan a actuar por cuenta propia se vuelven más potentes, y más difíciles de supervisar, cuando además pueden interpretar lo que ven y oyen en tiempo real.
Computer Use, la función presentada por Anthropic con Claude 3.5 Sonnet en octubre de 2024, es un ejemplo concreto: el modelo ve la pantalla del ordenador como una imagen, interpreta los elementos visuales de la interfaz y ejecuta acciones sin necesidad de acceso a la API de cada aplicación. Funciona con cualquier software que tenga interfaz visual, lo que lo hace mucho más versátil que los automatizadores tradicionales basados en código.
La pregunta que queda sin respuesta clara es cuánto control real conserva el usuario cuando delega en un agente multimodal que percibe el contexto de forma autónoma. Los mecanismos de supervisión actuales, básicamente instrucciones en lenguaje natural y límites de permisos, no están diseñados para sistemas que pueden interpretar y actuar sobre cualquier señal visual o auditiva que reciban. La tecnología avanza más rápido que los marcos de control, como suele ocurrir. Y esta vez, la distancia entre ambos es especialmente visible.
Preguntas frecuentes
¿Qué diferencia hay entre una IA multimodal y una IA de texto normal?
Una IA de texto solo procesa y genera lenguaje escrito. Una IA multimodal puede recibir y combinar distintos tipos de entrada, como imágenes, audio o vídeo, y relacionarlos entre sí para generar respuestas más completas. La clave no es que admita varios formatos, sino que los procesa de forma conjunta, no como canales separados.
¿GPT-4o es realmente mejor que los modelos anteriores en imagen y voz?
En integración nativa, sí. GPT-4o procesa texto, imagen y audio en un único modelo en vez de encadenar sistemas separados, lo que reduce la pérdida de información entre modalidades y mejora la latencia en conversaciones de voz. Eso no significa que sea mejor en todas las tareas concretas: en benchmarks específicos de visión, Gemini 1.5 Pro le supera en algunas pruebas.
¿Son fiables los diagnósticos médicos que hace una IA multimodal?
Los modelos médicos multimodales muestran resultados prometedores en estudios controlados, pero no están validados como herramienta diagnóstica independiente. Su uso clínico real requiere supervisión de un especialista. Los errores en la fusión de modalidades, por ejemplo, cruzar mal una imagen de radiología con un historial clínico, pueden producir conclusiones incorrectas que no son fáciles de detectar.
¿Pueden estos modelos reconocer emociones de verdad?
Los modelos multimodales detectan patrones asociados a emociones básicas en voz e imagen con una fiabilidad razonable en condiciones estándar. No “reconocen” emociones en el sentido humano: hacen inferencias estadísticas a partir de señales de entrenamiento. Ante ironía, contexto cultural específico o emociones mixtas, el rendimiento cae de forma notable y el modelo puede equivocarse sin señalarlo.
¿Los sesgos de los modelos multimodales son más graves que los de los modelos de texto?
Son distintos y, en algunos aspectos, más difíciles de auditar. Los sesgos visuales, como la sobrerepresentación de ciertas etnias o contextos en los datos de entrenamiento, interactúan con los sesgos textuales de formas que los métodos de auditoría actuales no capturan bien. Eso no los hace necesariamente más graves, pero sí más opacos.
¿Qué riesgos tiene usar un agente de IA multimodal que controla mi ordenador?
El riesgo principal es la pérdida de supervisión real sobre lo que el agente hace. Un sistema que ve tu pantalla, interpreta sus elementos y ejecuta acciones tiene acceso a información sensible y puede cometer errores difíciles de revertir. Los mecanismos de control actuales son rudimentarios para el nivel de autonomía que estos sistemas ya tienen en versiones de demostración.