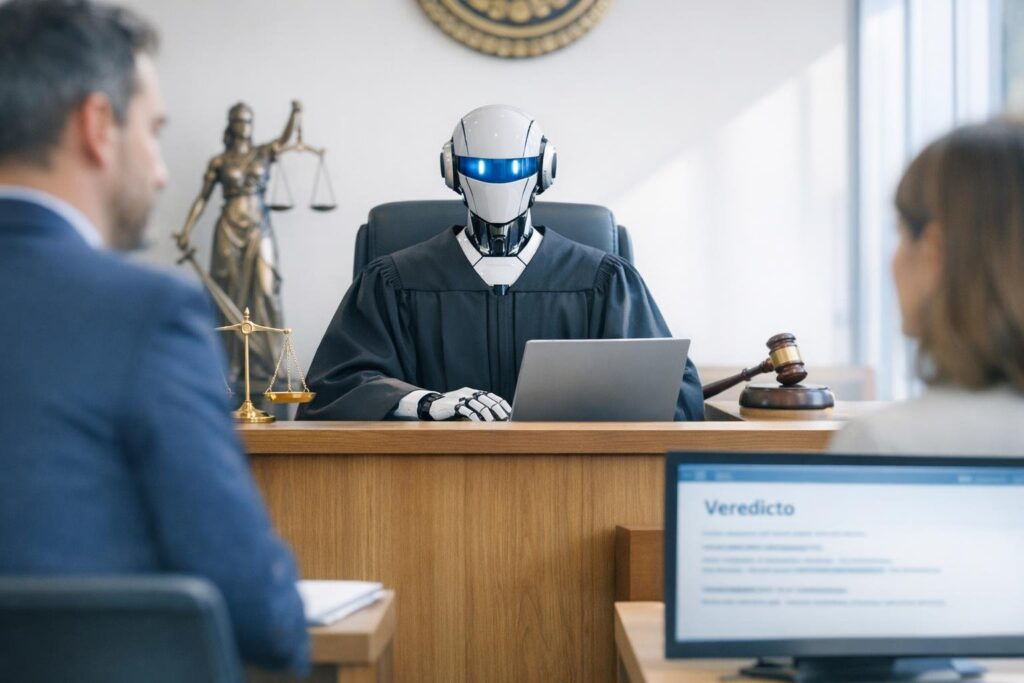
Los sistemas de IA, justicia y algoritmos legales ya no son ciencia ficción: están tomando decisiones reales sobre libertad, custodia de menores y acceso a prestaciones sociales en docenas de países. El problema no es que estas herramientas existan, sino que a menudo nadie sabe muy bien quién responde cuando se equivocan.
En Estados Unidos, el sistema COMPAS lleva más de una década calculando el riesgo de reincidencia de personas acusadas de delitos. Los jueces reciben esa puntuación y, aunque no están obligados a seguirla, los estudios muestran que influye. En los Países Bajos, un tribunal administrativo usó un algoritmo para detectar fraude en ayudas sociales hasta que, en 2020, el escándalo destapó que el sistema había penalizado de forma desproporcionada a familias con doble nacionalidad. Miles de familias tuvieron que devolver dinero que no habían robado.
Estos no son casos aislados. Son el patrón.
¿Qué hace exactamente un algoritmo legal?
Un algoritmo legal es cualquier sistema automático que produce una recomendación o decisión con consecuencias jurídicas o administrativas para una persona. Eso incluye desde calcular la fianza que debe pagar un detenido hasta decidir si un solicitante de asilo cumple los requisitos para recibir protección. La palabra «recomendación» suena neutra, pero cuando un juez tiene delante una pantalla con una puntuación de riesgo, la recomendación ejerce una presión que es difícil ignorar.
Los algoritmos utilizados en la justicia penal suelen entrenarse con datos históricos de condenas, arrestos y comportamiento delictivo. El razonamiento es que los patrones del pasado predicen el futuro. El fallo de ese razonamiento es que los datos históricos reflejan también los sesgos históricos: si la policía históricamente ha vigilado más a ciertos barrios, los vecinos de esos barrios acumularán más entradas en las bases de datos, y el algoritmo aprenderá que vivir ahí es un factor de riesgo. No porque lo sea objetivamente, sino porque los datos están contaminados desde el origen.
ProPublica analizó en 2016 los resultados de COMPAS en el condado de Broward, Florida, y encontró que el sistema clasificaba erróneamente a acusados negros como de alto riesgo el doble de veces que a acusados blancos. Northpointe, la empresa que desarrolló COMPAS, disputó la metodología. La discusión académica sigue abierta, pero el caso consiguió que el debate saliera de los laboratorios y llegara a los juzgados.
¿Quién controla los algoritmos que controlan a los jueces?
La mayoría de los sistemas de IA aplicados a la justicia los desarrollan empresas privadas, no organismos públicos. Eso crea un problema inmediato: la opacidad comercial choca con el derecho a conocer los motivos de una decisión judicial. En varios casos en Estados Unidos, los abogados defensores han pedido acceder al código fuente de COMPAS para impugnarlo. Los tribunales han rechazado mayoritariamente esas peticiones, argumentando que el código es propiedad intelectual de la empresa.
La consecuencia práctica es absurda: un ciudadano puede ser enviado a prisión preventiva o recibir una pena más severa en parte porque un algoritmo así lo aconseja, y ni él ni su abogado pueden saber cómo funciona ese algoritmo. Los límites que las empresas programan en sus IA quedan así fuera del escrutinio público, incluso cuando esas IA tienen consecuencias penales.
En Europa, el Reglamento de Inteligencia Artificial aprobado en 2024 clasifica como «alto riesgo» los sistemas de IA usados en administración de justicia y aplicación de la ley. Eso obliga a los desarrolladores a documentar su funcionamiento, a que sean auditables y a garantizar supervisión humana. Sobre el papel, es un avance. En la práctica, la implementación será lenta y el margen de interpretación, amplio.
China ha ido en otra dirección. El sistema «Sistema 206», desplegado en varias fiscalías, analiza expedientes y emite recomendaciones de cargos penales. Las autoridades lo presentan como una herramienta de eficiencia y coherencia. Los críticos señalan que en un sistema judicial sin independencia real del poder político, automatizar las recomendaciones fiscales refuerza el control del Estado, no la imparcialidad.
¿Pueden los algoritmos ser más justos que los humanos?
Los sesgos humanos en la justicia están documentados desde hace décadas, y los datos son incómodos. Un estudio publicado en 2011 analizó más de mil decisiones de libertad condicional en Israel y encontró que la probabilidad de que un preso obtuviera la libertad era significativamente más alta justo después del descanso del juez para comer. Con el estómago vacío, los jueces tendían a negar más peticiones. La fatiga y el hambre afectan al derecho tanto como cualquier sesgo más ideológico.
Los defensores de los algoritmos argumentan que un sistema automático, al menos, aplica los mismos criterios siempre. No se cansa, no tiene hambre, no tiene un mal día. Eso es cierto. Lo que también es cierto es que cuando un humano comete un error, existe la posibilidad de entender por qué y corregirlo. Cuando lo comete un algoritmo opaco, hay límites muy concretos para lo que cualquier IA puede comprender sobre sus propias decisiones.
El argumento de que los algoritmos son más neutrales ignora que la neutralidad no existe en el diseño. Alguien elige qué variables incluir en el modelo, qué datos usar para entrenarlo y qué peso dar a cada factor. Esas decisiones no son técnicas en sentido puro: son decisiones sobre qué tipo de sociedad queremos. Y esas decisiones las toman personas concretas, con intereses concretos, a menudo en una empresa privada con un contrato gubernamental.
Hay investigaciones que sugieren que algunos modelos predictivos bien diseñados sí reducen ciertas disparidades raciales respecto a las decisiones humanas históricas. El matiz importa: reducir una injusticia no significa producir justicia. Y compararse con el peor desempeño humano es un listón muy bajo.
¿Qué pasa en España con la IA y la justicia?
En España, el uso de algoritmos en el sistema judicial es todavía limitado comparado con Estados Unidos o con algunos países del norte de Europa. El Consejo General del Poder Judicial ha explorado herramientas de IA para gestión documental y análisis de jurisprudencia, pero no existen sistemas de predicción de reincidencia implementados de forma generalizada en los tribunales españoles. Al menos no que sean públicamente conocidos.
Donde sí se han usado algoritmos con consecuencias jurídicas es en la administración pública. El sistema Bosco, usado por el Ministerio para la Transición Ecológica para gestionar el bono social eléctrico, fue señalado por la organización Eticas Foundation como un caso de uso de IA de alto riesgo sin las garantías adecuadas. El sistema tomaba decisiones que afectaban directamente al acceso de familias vulnerables a prestaciones energéticas. El Ministerio respondió que el sistema solo automatizaba tareas administrativas. La frontera entre «automatizar tareas» y «tomar decisiones» es exactamente el terreno en disputa.
La Agencia Española de Supervisión de la Inteligencia Artificial (AESIA), creada en 2023, tiene entre sus funciones supervisar el cumplimiento del Reglamento europeo de IA. Los marcos legales que rodean a la IA están formándose ahora mismo, con todo lo que eso implica de incertidumbre e improvisación.
Que España no tenga COMPAS no significa que esté a salvo del problema. Significa que está un poco más atrás en la curva, con tiempo para aprender de los errores ajenos si hay voluntad política de hacerlo.
¿Qué ocurre cuando el algoritmo se equivoca y nadie lo sabe?
El caso holandés mencionado al principio tuvo una resolución: el tribunal supremo declaró ilegal el sistema en 2020 y el gobierno tuvo que indemnizar a miles de familias. Fue posible porque hubo periodistas, activistas y abogados que tiraron del hilo. Los algoritmos que moldean decisiones sobre personas no suelen anunciarse ni dejan rastros fáciles de seguir.
El riesgo más profundo no es el algoritmo que claramente discrimina y acaba en los titulares. Es el algoritmo que produce pequeñas injusticias sistemáticas, invisibles una a una, que se acumulan durante años sin que nadie las agregue ni las denuncie. Cada error parece un caso aislado. El patrón solo se ve cuando alguien tiene acceso a todos los datos y los analiza juntos.
La opacidad es el mayor problema, más que la automatización en sí. Un algoritmo auditable, revisable y con mecanismos de impugnación accesibles podría coexistir con el Estado de derecho. Un algoritmo opaco en manos de una empresa privada con contrato gubernamental es otra cosa.
Para que existan esos mecanismos de impugnación, hace falta que los ciudadanos sepan que el algoritmo existe, que los jueces entiendan sus limitaciones, y que los abogados defensores tengan herramientas reales para cuestionarlo. Las tres condiciones fallan con frecuencia. Cómo aprenden estos modelos sin supervisión humana es una pregunta que los propios desarrolladores a veces no saben responder del todo.
Hay un detalle que suele pasarse por alto en este debate: cuando un juez humano toma una decisión injusta, existe al menos la posibilidad teórica de pedirle cuentas, de que declare en un recurso, de que explique su razonamiento. El algoritmo no declara. No se sienta ante nadie. La responsabilidad se diluye entre el desarrollador, el comprador público y el juez que lo usa, y al final nadie acaba siendo responsable de nada.
Algunos países están empezando a exigir lo que se llama «explicabilidad algorítmica»: la obligación de que cualquier sistema que tome o recomiende decisiones con consecuencias para personas pueda dar cuenta de por qué llegó a esa conclusión. Es un requisito que tiene sentido. El problema es que muchos modelos de aprendizaje automático, especialmente los basados en redes neuronales profundas, funcionan de formas que ni sus propios creadores pueden explicar con precisión. El volumen de datos que alimenta estos sistemas hace que la trazabilidad de una decisión concreta sea, en muchos casos, imposible en la práctica.
No es un problema técnico menor que se resolverá con más potencia de cálculo. Es una tensión estructural entre cómo funcionan ciertos tipos de IA y lo que exige el Estado de derecho.
¿Llegará un día en que el algoritmo tenga más poder que el juez?
La respuesta honesta es que en algunos contextos ese día ya llegó, aunque nadie lo haya declarado oficialmente. Cuando un juez no tiene recursos para revisar un expediente con detalle y una herramienta automatizada le da una puntuación de riesgo, la puntuación decide. El peso real del algoritmo no está en la ley, sino en la práctica cotidiana de un sistema judicial sobrecargado.
El futuro no depende de si los algoritmos son más o menos inteligentes que los jueces. Depende de si la sociedad decide que las decisiones que afectan a la libertad de las personas deben poder explicarse, cuestionarse y, cuando son erróneas, corregirse. Eso no es una cuestión técnica. Es una cuestión política.
Lo que sí puede hacer la tecnología es ayudar a que los jueces trabajen mejor, tengan acceso a más jurisprudencia relevante y cometan menos errores por agotamiento. La IA como asistente que informa sin sustituir es un modelo diferente al de la IA que decide. La diferencia entre esos dos modelos es donde se juega todo.
La pregunta que ningún tribunal ha respondido todavía es quién juzga al juez automático cuando falla. Y esa pregunta no tiene respuesta técnica.
Preguntas frecuentes
¿Qué es un algoritmo de riesgo de reincidencia?
Es un sistema que analiza datos de una persona acusada o condenada (antecedentes, perfil socioeconómico, comportamiento previo) y emite una puntuación que estima la probabilidad de que vuelva a delinquir. Esa puntuación puede influir en decisiones judiciales como la fianza, la sentencia o la concesión de libertad condicional. El debate está en si esos cálculos son fiables y justos.
¿Es legal en Europa usar IA para tomar decisiones judiciales?
El Reglamento de Inteligencia Artificial de la UE, aprobado en 2024, clasifica como «alto riesgo» los sistemas de IA en el ámbito judicial y exige supervisión humana, auditorías y documentación. No prohíbe su uso, pero impone condiciones estrictas. El grado de cumplimiento real dependerá de cómo cada estado miembro implemente la norma en los próximos años.
¿Puede una persona recurrir una decisión tomada por un algoritmo?
Teóricamente sí, sobre todo en Europa, donde el RGPD reconoce el derecho a no ser objeto de decisiones completamente automatizadas con efectos significativos. En la práctica, recurrir es difícil porque el ciudadano pocas veces sabe que hubo un algoritmo implicado, y acceder al funcionamiento del sistema suele toparse con la protección de secreto comercial.
¿Son los algoritmos más racistas que los jueces humanos?
No hay una respuesta simple. Algunos estudios, como el análisis de ProPublica sobre COMPAS en 2016, encontraron sesgos raciales significativos en las predicciones. Otros investigadores discutieron la metodología. Los jueces humanos también muestran sesgos documentados. El problema es que los sesgos algorítmicos se aplican a escala masiva y de forma sistemática, lo que amplifica su impacto.
¿España usa algoritmos en sus tribunales?
No existen sistemas de predicción de reincidencia generalizados en los tribunales españoles. Sí se han detectado usos de algoritmos en la administración pública con consecuencias sobre prestaciones sociales, como el caso del sistema Bosco. La Agencia Española de Supervisión de la Inteligencia Artificial tiene mandato para supervisar estos usos, aunque lleva poco tiempo operativa.
¿Qué significa «explicabilidad algorítmica» en el contexto judicial?
Significa la capacidad de un sistema de IA para dar cuenta de por qué tomó o recomendó una decisión concreta. En el ámbito judicial es especialmente importante porque el derecho a conocer los motivos de una resolución es un principio básico del Estado de derecho. El problema técnico es que muchos modelos avanzados de IA no pueden explicar su propio razonamiento de forma comprensible.


