La medicina personalizada genómica ya no es una promesa de ciencia ficción: hoy existen tratamientos oncológicos que se prescriben en función de las mutaciones concretas del tumor de cada paciente, no del órgano donde aparece. El cambio de lógica es profundo. Durante siglos, la medicina funcionó buscando patrones comunes entre enfermos parecidos; ahora, cada vez más, busca lo que te hace diferente a ti.
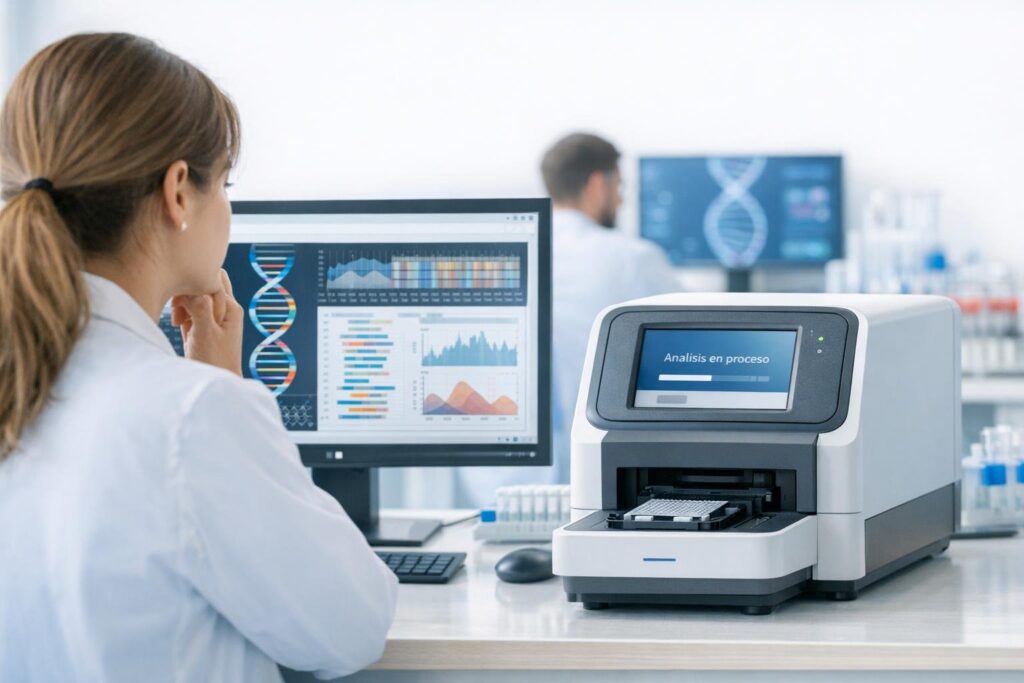
El modelo tradicional asumía que dos personas con el mismo diagnóstico necesitaban el mismo tratamiento. La genómica ha demostrado que eso es, en muchos casos, una simplificación peligrosa. Dos tumores de mama con el mismo aspecto al microscopio pueden tener perfiles moleculares completamente distintos, y responder de forma opuesta al mismo fármaco.
¿Qué es exactamente la medicina personalizada genómica?
La medicina personalizada genómica es el uso de la información del ADN de un paciente, y a veces del ADN de su enfermedad, para tomar decisiones clínicas más precisas. La idea central es sencilla: si conoces las variantes genéticas de una persona, puedes anticipar qué fármacos metabolizará mejor, qué enfermedades tiene más probabilidad de desarrollar y qué tratamientos le harán daño antes de que ese daño ocurra.
La rama que lo lleva más lejos en la práctica clínica actual es la oncología de precisión. Empresas como Foundation Medicine (filial de Roche) ofrecen análisis genómicos completos de tumores que permiten al oncólogo ver qué mutaciones impulsan el crecimiento del cáncer. Con esa información, puede elegir un inhibidor diseñado específicamente para esa mutación, en vez de aplicar quimioterapia de espectro amplio.
Pero el alcance va más allá del cáncer. La farmacogenómica estudia cómo los genes afectan a la respuesta a los medicamentos en general. La variante CYP2C19, por ejemplo, determina la velocidad a la que el hígado metaboliza el clopidogrel, un antiagregante muy usado tras infartos. Un paciente con metabolismo lento puede sufrir otro infarto tomando la dosis estándar, porque su cuerpo no la activa bien. Hay tests genéticos que ya detectan esto antes de que el médico recete.
La farmacogenómica encaja también con la conversación más amplia sobre cómo la tecnología entra dentro del cuerpo del paciente para mejorar el seguimiento del tratamiento. La dirección de viaje es la misma: menos ensayo y error, más información de partida.
¿Cómo entra el algoritmo en todo esto?
El algoritmo entra porque el genoma humano tiene unos tres mil millones de pares de bases, y ningún médico puede leerlos, interpretarlos y cruzarlos con miles de estudios clínicos en el tiempo que dura una consulta. Los modelos de inteligencia artificial son el componente que convierte el dato genético en recomendación clínica accionable.
IBM Watson for Oncology fue uno de los primeros intentos a gran escala de llevar esto a hospitales reales. Los resultados fueron mixtos: en algunos tipos de tumor coincidía con los oncólogos humanos en más del 90% de los casos; en otros, las recomendaciones eran tan discutibles que varios hospitales abandonaron el sistema. El caso ilustra bien el estado real de la disciplina: la IA es útil pero no infalible, y su rendimiento depende mucho de con qué datos fue entrenada.
Hoy los sistemas más prometedores no intentan reemplazar al médico sino ayudarlo a priorizar. Alphafold, el modelo de DeepMind que predice la estructura tridimensional de las proteínas, ha acelerado la identificación de dianas terapéuticas de forma notable. En 2022, DeepMind publicó las estructuras predichas de casi todas las proteínas conocidas. Para la industria farmacéutica, eso fue como recibir un mapa donde antes había manchas en blanco.
La misma lógica de algoritmos entrenados sobre datos masivos está detrás de la carrera por los asistentes de IA que grandes tecnológicas y startups libran en paralelo. En medicina, esa carrera tiene consecuencias directas sobre qué paciente recibe qué tratamiento.
¿Qué enfermedades se tratan ya con medicina personalizada?
El cáncer es el campo donde la medicina personalizada genómica tiene más aplicación clínica real hoy mismo. Los inhibidores de EGFR para ciertos cánceres de pulmón, el trastuzumab para tumores HER2 positivos, o el imatinib para la leucemia mieloide crónica con la mutación BCR-ABL son ejemplos concretos de fármacos que solo funcionan en pacientes con un perfil genético específico. Sin el test previo, prescribirlos sería disparar a ciegas.
Fuera del cáncer, la genómica también ha cambiado el tratamiento de enfermedades raras con base genética clara. El ivacaftor, aprobado por la FDA en 2012 para la fibrosis quística, solo es eficaz en pacientes con la mutación G551D en el gen CFTR. El fármaco fue diseñado para esa mutación específica, no para la enfermedad en abstracto. Es un modelo que ahora se intenta replicar en cientos de otras patologías.
Las enfermedades cardiovasculares, las psiquiátricas y algunas autoinmunes están en fases más tempranas, pero la investigación avanza. En psiquiatría, por ejemplo, se trabaja en tests que ayuden a predecir qué antidepresivo responderá mejor en cada paciente, una área donde hoy el proceso sigue siendo demasiado basado en la prueba y el error.
Todo esto también conecta con debates más amplios sobre quién controla los datos que generan estas tecnologías. La concentración de datos en pocas manos es un problema que se repite en sectores muy distintos, y la genómica no es una excepción.
¿Quién tiene acceso a tu genoma y qué hace con él?
Secuenciar un genoma completo cuesta hoy menos de 200 dólares en algunos laboratorios de Estados Unidos, frente a los 2.700 millones que costó el Proyecto Genoma Humano en 2003. El precio ha bajado más rápido que para cualquier otra tecnología en la historia reciente, más incluso que la Ley de Moore para los chips. El acceso técnico ya no es el problema principal. Lo que genera más debate es quién custodia esos datos.
23andMe fue durante años la empresa de tests genéticos de consumo más conocida del mundo. En 2023 sufrió una filtración que expuso datos genéticos de casi siete millones de usuarios. En 2024, la compañía entró en concurso de acreedores. Los datos genéticos de millones de personas quedaron en una situación legalmente ambigua: ¿quién los compraría en caso de liquidación? ¿Bajo qué condiciones podrían reutilizarse?
Las legislaciones van detrás de los hechos. En Europa, el Reglamento General de Protección de Datos clasifica los datos genéticos como categoría especial, con protección reforzada. En Estados Unidos, la GINA (Genetic Information Nondiscrimination Act) prohíbe que las aseguradoras de salud y los empleadores discriminen por información genética, pero tiene lagunas: no cubre seguros de vida ni de cuidados de larga duración.
El debate sobre privacidad genética tiene una particularidad que lo hace único: cuando compartes tu ADN, compartes también información sobre tus familiares biológicos, que no han dado su consentimiento. Ninguna otra categoría de datos personales funciona así.
Este tipo de tensión entre posibilidades tecnológicas y marcos legales insuficientes recuerda al debate sobre hasta qué punto confiamos nuestros datos más sensibles a sistemas digitales sin entender bien qué ocurre con ellos después.
Las zonas grises: lo que la genómica todavía no puede hacer
La medicina personalizada genómica tiene límites reales que conviene no ignorar. El primero es que la mayoría de las enfermedades comunes, incluidas las cardiovasculares, la diabetes tipo 2 o la mayoría de los trastornos mentales, son poligénicas. Las determina la interacción de centenares o miles de variantes genéticas, más el ambiente, más el estilo de vida. Los tests genéticos que prometen predecir tu riesgo de estas enfermedades con precisión están, en muchos casos, sobrevendidos.
Los “scores de riesgo poligénico” (PRS, por sus siglas en inglés) son herramientas legítimas de investigación epidemiológica, pero su utilidad clínica individual sigue siendo limitada para la mayoría de condiciones. Un PRS elevado para enfermedad coronaria no significa que vayas a tener un infarto; significa que estás en un grupo estadístico de mayor riesgo, lo que es útil para poblaciones pero impreciso para individuos.
El segundo límite es la representatividad de los datos. La mayor parte de los grandes estudios genómicos se han realizado sobre poblaciones de ascendencia europea. Eso significa que los modelos predictivos funcionan peor para personas de otras etnias, perpetuando desigualdades sanitarias en nombre de la precisión.
Y luego está el acceso económico. Los análisis genómicos avanzados cuestan miles de euros y no siempre están cubiertos por los sistemas públicos de salud. La medicina personalizada, tal como está desarrollándose ahora, corre el riesgo de convertirse en tecnología de élite durante demasiado tiempo antes de democratizarse.
Los algoritmos tampoco están libres de sesgos. Si un modelo de IA se entrena con datos de pacientes de hospitales privados de alta renta, sus recomendaciones pueden ser menos precisas para pacientes de contextos diferentes. La potencia computacional necesaria para procesar genomas a gran escala también sigue siendo un factor de concentración: la tienen pocas empresas y pocos países.
Hay además una pregunta ética que la medicina personalizada genómica no puede esquivar: si los seguros privados accedieran a tu perfil genético, ¿usarían esa información para excluirte de la cobertura antes de que enfermes? Los marcos legales actuales intentan evitarlo, pero la presión del sector asegurador por acceder a esos datos es real y documentada.
¿Llegará la medicina personalizada a todos o seguirá siendo privilegio de pocos?
La pregunta no tiene respuesta clara todavía, y eso es parte de la respuesta. La trayectoria histórica de otras tecnologías médicas, desde las vacunas hasta los escáneres de resonancia magnética, sugiere que el acceso se amplía con el tiempo, pero el tiempo puede ser mucho. Y en medicina, esperar tiene un coste que se mide en años de vida.
Algunos sistemas públicos europeos, el NHS británico entre ellos, han empezado a integrar la secuenciación genómica en sus protocolos oncológicos. El Proyecto Genomas 100.000 del Reino Unido, que secuenció el genoma de 100.000 pacientes del NHS entre 2012 y 2018, fue uno de los primeros intentos de hacerlo a escala poblacional dentro de un sistema público. Los resultados alimentaron bases de datos que hoy siguen usándose para investigación clínica.
España tiene el Plan de Medicina de Precisión, impulsado desde el Instituto de Salud Carlos III, aunque su implementación real en el sistema sanitario público es todavía desigual según la comunidad autónoma. La distancia entre el laboratorio de investigación y la consulta del médico de familia sigue siendo grande.
La genómica de precisión también plantea preguntas que van más allá del sistema sanitario. Si puedes saber con antelación que tienes alta probabilidad de desarrollar una enfermedad neurodegenerativa, ¿quieres saberlo? ¿Tiene tu familia derecho a saberlo también? La información genética cambia la relación con el futuro, y no todo el mundo está preparado para eso del mismo modo. Eso no es un problema técnico: es un problema humano que la medicina personalizada arrastra consigo y que los algoritmos no resuelven.
Lo que sí parece claro es que la dirección de la medicina apunta hacia la individualización creciente. La biología computacional, los modelos que procesan información celular y la genómica van convergiendo. El ritmo al que esa convergencia llegue a los pacientes de a pie dependerá menos de la ciencia que de las decisiones políticas, económicas y éticas que tomemos en los próximos años.
Preguntas frecuentes
¿Qué diferencia hay entre medicina personalizada y medicina convencional?
La medicina convencional trata enfermedades buscando lo que los pacientes tienen en común; la medicina personalizada busca lo que los diferencia. En la práctica, esto significa usar información genética, molecular o de biomarcadores para elegir el tratamiento más probable que funcione en una persona concreta, en vez de aplicar el estándar estadístico para la mayoría.
¿Es seguro hacerse un test genético comercial como los de 23andMe?
Los tests en sí son técnicamente fiables para lo que miden. El problema no es la prueba sino qué pasa con tus datos después. Las condiciones de uso de estas empresas permiten, en muchos casos, compartir datos anonimizados con terceros para investigación. Tras la quiebra de 23andMe en 2024, la seguridad a largo plazo de esos datos quedó en entredicho. Conviene leer la letra pequeña antes de escupir en un tubo.
¿Puede la medicina personalizada curar el cáncer?
No curarlo en general, pero sí mejorar significativamente los resultados en tipos concretos. Algunos cánceres con mutaciones específicas responden muy bien a inhibidores diseñados para esa mutación. En otros casos, el tumor acaba desarrollando resistencia. La oncología de precisión ha alargado la supervivencia en muchos pacientes, pero no es una solución universal para todos los tipos de cáncer.
¿Cómo sé si mi médico usa medicina personalizada?
Depende del tipo de enfermedad y del sistema sanitario donde te atiendas. En oncología, los hospitales de referencia en España y Europa hacen pruebas de perfil molecular del tumor antes de elegir ciertos tratamientos. En otras especialidades, la implantación es menor. Si tienes un diagnóstico oncológico, puedes preguntar directamente a tu oncólogo si existe un test genómico relevante para tu caso.
¿Pueden las aseguradoras usar mi ADN para negarme cobertura?
En Europa, el RGPD protege los datos genéticos como categoría especial y limita su uso comercial. En España, la ley prohíbe la discriminación por datos genéticos en el acceso a seguros de salud. Sin embargo, las lagunas legales existen, sobre todo en seguros de vida y en países con marcos más laxos. El riesgo teórico es real aunque hoy no está documentado como práctica generalizada.
¿Es fiable que un algoritmo decida mi tratamiento?
Los algoritmos actuales no deciden solos: apoyan al médico con información que este no podría procesar manualmente. Su fiabilidad depende de los datos con que fueron entrenados y del tipo de enfermedad. En oncología, algunos sistemas muestran concordancia alta con expertos humanos en ciertos tumores. En otros contextos, el margen de error es suficientemente grande como para no usarlos sin supervisión clínica estricta.